Evaluering av kvaliteten på KI-genererte bildebeskrivelser i digitale læremidler
Publisert: 19.10.2026
- Stephen Simei Kimogol - Statped
- Dan Nachtnebel - Statped
- Mugula Chris Safari - Statped
- Norun Christine Sanderson - OsloMet
Dette er en oversatt og forkortet versjon av en forskningsartikkel. Forskningsartikkelen finnes i sin helhet på ACM Digital Library (Åpnes i ny fane) (Krever betalt tilgang)
Sammendrag
Digitale læremidler gir muligheter for inkluderende opplæring, men mangelfulle bildebeskrivelser gjør dem ofte bare delvis tilgjengelige for elever med synsnedsettelse. Å skrive gode bildebeskrivelser er arbeidskrevende og krever pedagogisk kompetanse, fagkompetanse og forståelse for bildets funksjon i konteksten. Generativ kunstig intelligens (KI) kan lage bildebeskrivelser automatisk, men kvaliteten i utdanningssammenheng er lite utforsket. Denne studien evaluerer KI-genererte bildebeskrivelser når modellene får kontekstuell informasjon som tilhørende tekstavsnitt, lærerveiledninger, kompetansemål samt fag- og trinnopplysninger. Vi testet GPT-5.2, Claude-opus-4.5 og Gemini-3-pro med 30 bilder fra norske læremidler i naturfag og samfunnsfag under to betingelser: kun bilde og bilde med kontekst. Beskrivelsene ble vurdert i en nettbasert spørreundersøkelse og i en ekspertworkshop. Funnene viser at modellene lager altfor lange og tolkende beskrivelser, og at de behandler kontekst som innhold som skal legges til, snarere enn som et filter for hva som kan utelates. Dette kan gi økt kognitiv belastning for skjermleser- og punktskriftbrukere og endre den pedagogiske intensjonen med bildet. KI kan bidra til effektivitet, men menneskelig kvalitetssikring er fortsatt avgjørende for at beskrivelsene skal bli korrekte, tilgjengelige og pedagogisk hensiktsmessige.
1 Innledning
Bilder i læremidler støtter forståelse og engasjement, og de formidler ofte informasjon som ikke finnes i teksten, eller forsterker sentrale begreper (Chung, 2024; Huntsman, 2022; McElvany mfl., 2012). Når mening er fordelt mellom bilde og tekst, blir tilgang til det visuelle innholdet en forutsetning for full deltakelse i læringen. Blinde og sterkt svaksynte elever får tilgang til visuelt innhold gjennom taktil grafikk eller tekstbaserte bildebeskrivelser (Morash mfl., 2015). For at beskrivelsene skal fungere i opplæringen, må de være presise, relevante for konteksten og lette å forstå (Bertelsen, 2024; Hoppe mfl., 2021).
Likevel mangler bilder ofte alternativ tekst. En undersøkelse av én million nettsteders forsider fant at 55,5 % manglet alternativ tekst helt (WebAIM, 2025), og tilgjengelighetsevalueringer vektlegger ofte at alternativ tekst finnes, snarere enn hvor nyttig eller korrekt den er (Kreiss mfl., 2022; Leotta mfl., 2023). Dette gjenspeiler en utbredt misforståelse av alternativ tekst som et teknisk krav, ikke som et virkemiddel for å skape mening (Huntsman, 2022). Utfordringene er særlig betydningsfulle i Norge, der bruken av digitale læremidler er utbredt.
I denne studien evaluerer vi kvaliteten på KI-genererte bildebeskrivelser i digitale læremidler når modellene får kontekstuell informasjon som foregående avsnitt, delkapitteloverskrift, figurtekst, lærerveiledning, kompetansemål samt trinn- og fagopplysninger. Lærere, redaktører, utviklere, tilgjengelighetsrådgivere og andre fagpersoner vurderte beskrivelsenes klarhet og effektivitet i en nettbasert spørreundersøkelse. I tillegg gjorde spesialister fra Statped, som tilrettelegger materiell for elever med synsnedsettelse og skriver bildebeskrivelser, en dyptgående vurdering i en workshop.
2 Relatert forskning
Vi oppsummerer her forskning om bildebeskrivelse og om automatiske og kontekstbevisste bildebeskrivelser.
2.1 Bildebeskrivelse
Litteraturen skiller vanligvis mellom tre typer bildebeskrivelser (Hodosh mfl., 2013; Hollink mfl., 2004; Shatford, 1986). Konseptuelle beskrivelser identifiserer hva bildet viser. Ikke-visuelle beskrivelser gir bakgrunnsinformasjon som ikke kan utledes av bildet alene, for eksempel opphav, tid eller sted. Perseptuelle beskrivelser fanger visuelle egenskaper som bildetype, farge og form.
Alternativ tekst er den viktigste mekanismen som gjør bilder tilgjengelige for skjermlesere gjennom tale og leselist, og den kan suppleres av lengre beskrivelser når bilder inneholder kompleks informasjon. Hva som er passende lengde, er fortsatt omdiskutert: mange retningslinjer anbefaler korthet, mens forskning tyder på at brukere i visse situasjoner foretrekker mer detaljerte beskrivelser av komplekse bilder (Morris mfl., 2018). I denne artikkelen brukes begrepene alternativ tekst og bildebeskrivelse om hverandre.
W3C Web Accessibility Initiative (2022) deler bilder inn i blant annet informative, dekorative, funksjonelle og komplekse bilder, og understreker at beskrivelser bør skrives ut fra bildets formål og konteksten det brukes i. Likevel er det sjelden opplagt hva en beskrivelse bør inneholde, og gode beskrivelser krever både fagkompetanse og skjønn (Cardia mfl., 2025; Hanley mfl., 2021). Hva som utgjør en god bildebeskrivelse, er utilstrekkelig utforsket, og det er begrenset enighet om beste praksis (Jandrey mfl., 2023; Kreiss mfl., 2022; Y. Shen mfl., 2025). Tilgjengelige retningslinjer spenner fra generelle anbefalinger (American Foundation for the Blind, 2026; DIAGRAM Center & NCAM, 2015; Perkins School for the Blind, 2026) til veiledning for digitale læremidler (Bertelsen, 2024; Chee & Weaver, 2023; Standard Norge, 2025), for STEM-bilder (National Center for Accessible Media, 2009) og for vurderingssituasjoner (NWEA, 2021).
Felles for retningslinjene er at beskrivelser bør være korte, klare og rettet mot bildets funksjon i konteksten. Mange anbefaler en trinnvis oppbygning der en kort beskrivelse gis først, med utdyping ved behov, og at figurtekst og omkringliggende tekst brukes til å formidle detaljer og pedagogisk mening i stedet for å legge alt i den alternative teksten (Cardia mfl., 2025; Standard Norge, 2025). Alternativ tekst bør dessuten være objektiv og nøytral og unngå tolkning (DIAGRAM Center & NCAM, 2015; Risi, 2025a).
2.2 Automatiske og kontekstbevisste bildebeskrivelser
Generativ KI har vist betydelig potensial for å lage korrekte og kontekstbevisste bildebeskrivelser (Y. Shen mfl., 2025; Singh mfl., 2024; Wu mfl., 2017). Eksempler er AltGen, som genererer alternativ tekst i EPUB-publikasjoner og ga færre tilgjengelighetsfeil (Y. Shen mfl., 2025), og Figura11y, som støtter skriving av alternativ tekst til vitenskapelige figurer (Singh mfl., 2024). Forskning på samarbeid mellom menneske og KI viser at forfattere skrev bedre alternativ tekst når de startet fra en tom beskrivelse, enn når de redigerte automatisk genererte forslag (Mack mfl., 2021).
Kontekst verdsettes høyt av brukerne (Gubbi Mohanbabu & Pavel, 2024; Kreiss mfl., 2022), og evalueringsmetrikker samsvarer bedre med menneskelige vurderinger når kontekst er tilgjengelig (Kreiss mfl., 2022). Ett eksempel er en nettleserutvidelse som henter ut kontekst fra nettsiden, som sidetittel og omkringliggende tekst, og lar en stor språkmodell generere kontekstbevisste beskrivelser (Gubbi Mohanbabu & Pavel, 2024). Brukerne foretrakk disse beskrivelsene, men forfatterne advarer mot hallusinasjoner, altså innhold som ikke finnes i bildet, fordi slike feil kan virke mer troverdige når de bygger på kontekst. En komparativ studie (Risi, 2025b) fant at KI kan lage alternativ tekst med jevnt høy semantisk kvalitet i stor skala, men understreker behovet for menneskelig kontroll for å sikre korrekthet og pedagogisk hensiktsmessighet.
Tidligere studier har først og fremst sett på alternativ tekst for bilder i sosiale medier og på plattformer som Wikipedia (Leotta mfl., 2023; Wu mfl., 2017). Denne studien undersøker i stedet en utdanningskontekst. Med utgangspunkt i tilnærminger som utnytter rik kontekst (Gubbi Mohanbabu & Pavel, 2024; Kreiss mfl., 2022; Risi, 2025b), gir vi modellene omkringliggende tekst, lærerveiledninger, opplysninger om fag og trinn samt kompetansemål, som står sentralt i kompetanseorienterte læreplanverk (Bergheim, 2025; Sundby & Karseth, 2022).
3 Metode
Studien har et blandet metodedesign der kvantitative data fra en spørreundersøkelse kombineres med kvalitativ innsikt fra en ekspertworkshop, i tråd med tidligere vurderinger av KI-generert alternativ tekst (Y. Shen mfl., 2025). Dette gir både bredde i respondentenes perspektiver og dybde i ekspertvurderingene.
3.1 Bildesett, modeller og ledetekster
Datasettet besto av 30 bilder med tilhørende tekstmateriale fra digitale læremidler i naturfag og samfunnsfag, hentet med tillatelse fra forlagene og i samsvar med norsk opphavsrettslovgivning. Nasjonal digital læringsarena (NDLA), en offentlig finansiert tilbyder av åpne læringsressurser, bidro med 15 bilder fra første året i videregående. Elevkanalen (TV 2 Skole) bidro med 15 bilder fra 1. til 10. trinn. Andre forlag kunne ikke delta på grunn av opphavsrettslige begrensninger. For hvert bilde inngikk figurtekst, delkapitteloverskrift, foregående avsnitt, lærerveiledning og relevante kompetansemål. Både samfunnsfag og samfunnskunnskap omtales her som «samfunnsfag».
Vi evaluerte GPT-5.2, Claude-opus-4.5 og Gemini-3-pro-preview med to ledetekstmaler. Kun-bilde-malen ga modellen bildet, faget og trinnet. Med-kontekst-malen inkluderte i tillegg tittel, foregående avsnitt, figurtekst, relevant tekst fra lærerveiledningen (der den fantes) og kompetansemål. Begge malene ba modellen om kort og presis alternativ tekst forankret i fag og trinn og i samsvar med Web Content Accessibility Guidelines (WCAG) 2.1 (World Wide Web Consortium [W3C], 2018). Med-kontekst-malen ba i tillegg modellen ta hensyn til konteksten, utfylle snarere enn gjenta teksten og figurteksten, og unngå tolkende innhold.
Utdata fra store språkmodeller er svært følsomme for hvordan ledeteksten er formulert (Bezirhan & von Davier, 2023; Ripoll y Schmitz & Sonnleitner, 2025). Vi brukte zero-shot, altså ledetekster uten eksempler, fordi bildene spente over flere fag, bildetyper og trinn. Siden det å angi målgruppens trinn har vist seg å styre tekstens vanskegrad (Bezirhan & von Davier, 2023), spesifiserte ledetekstene eksplisitt trinn, krav til beskrivelsen og modellens rolle. Tabell 1 viser gjennomsnittlig lengde på beskrivelsene.
| Modell | Kun bilde | Med kontekst | Endring |
|---|---|---|---|
| GPT-5.2 | 188,0 | 186,9 | −1,1 |
| Claude-opus-4.5 | 265,7 | 261,3 | −4,3 |
| Gemini-3-pro | 247,7 | 215,8 | −32,0 |
3.2 Datainnsamling og analyse
Deltakerne ble rekruttert blant aktører med erfaring fra tilgjengelige læremidler for elever med synsnedsettelse. Spørreundersøkelsen ble sendt til skoler og lærere, læremiddelforlag og Den norske Forleggerforening. Den var anonym og frivillig og ble gjennomført i Nettskjema (Universitetet i Oslo). Workshopdeltakerne var fageksperter fra Statped med erfaring fra tilrettelegging av digitale læremidler for elever med synsnedsettelse. Studien ble godkjent av Sikt.
Spørreundersøkelsen omfattet 180 beskrivelser (30 bilder × 3 modeller × 2 betingelser). For å begrense arbeidsmengden ble bildene delt i tre randomiserte sett med ti bilder, og hver deltaker fikk tildelt ett sett. Deltakerne fikk vite fag og trinn for hvert bilde og vurderte hver beskrivelse etter klarhet og effektivitet på en firedelt skala (Svært dårlig, Dårlig, God, Utmerket). Alle spørsmål var valgfrie, og et kommentarfelt ga rom for åpne tilbakemeldinger.
Workshopen var en totimers digital samling med ni tilgjengelighetsspesialister og fageksperter fra Statped, inkludert én deltaker med synsnedsettelse, samt forskere. Kriteriene var klarhet, effektivitet, presisjon, konsishet og pedagogisk nytte. Ti bilder fra spørreundersøkelsen ble valgt ut, men fordi gjennomgangen av konteksten for hvert bilde var tidkrevende, rakk deltakerne å vurdere seks av dem.
Workshopen ble tatt opp, transkribert, anonymisert og analysert tematisk etter Braun og Clarke (2012). Spørreundersøkelsen ble oppsummert med deskriptiv statistikk, og fritekstsvarene ble sett i sammenheng med temaene fra workshopen.
4 Resultater
4.1 Resultater fra spørreundersøkelsen
Totalt ga 28 deltakere minst ett gyldig svar, til sammen 2 962 vurderinger. For klarhet ble 36,0 % av vurderingene «God», 33,6 % «Dårlig», 18,2 % «Utmerket» og 12,2 % «Svært dårlig». For effektivitet var tallene 35,6 % «God», 33,5 % «Dårlig», 19,4 % «Utmerket» og 11,6 % «Svært dårlig». Ytelsen var altså stort sett akseptabel, men med tydelige tilfeller av vesentlig svikt. Tabell 2 viser at kontekst ga noe bedring i klarhet og effektivitet for GPT-5.2 og Claude-opus-4.5, og stabil eller svakere ytelse for Gemini-3-pro. Beskrivelser av naturfagbilder fikk høyere skår enn beskrivelser av samfunnsfagbilder (tabell 3).
| Modell | Mål | Kun bilde | Med kontekst |
|---|---|---|---|
| Gemini-3-pro | Klarhet | 2,69 (0,95) | 2,61 (0,88) |
| Gemini-3-pro | Effektivitet | 2,74 (0,98) | 2,72 (0,91) |
| Claude-opus-4.5 | Klarhet | 2,72 (0,98) | 2,74 (0,91) |
| Claude-opus-4.5 | Effektivitet | 2,52 (0,92) | 2,66 (0,90) |
| GPT-5.2 | Klarhet | 2,40 (0,92) | 2,45 (0,83) |
| GPT-5.2 | Effektivitet | 2,50 (0,92) | 2,61 (0,87) |
I kommentarfeltet påpekte deltakerne at det er krevende å vurdere bildebeskrivelser uten kjennskap til hele konteksten og bildets formål. Flere kritiserte beskrivelser som tolker bildet i stedet for å beskrive det, og understreket at «alternativ tekst skal være rent beskrivende» og ikke «frata eleven muligheten til å tolke selv». Andre merknader gjaldt korrekte beskrivelser koblet med feilaktige tolkninger, overforklaring, gjentakelser, hallusinerte visuelle elementer og språk som ikke passet trinnet.
| Fag | Klarhet | Effektivitet | Antall vurderinger |
|---|---|---|---|
| Naturfag | 2,76 | 2,75 | 1 330 |
| Samfunnsfag | 2,47 | 2,53 | 1 632 |
4.2 Resultater fra workshopen
Den tematiske analysen av ekspertvurderingene ga fem sammenvevde temaer.
Altfor lange beskrivelser
Ekspertene vektla korthet fremfor uttømmende visuelle detaljer. Beskrivelser skulle utfylle, ikke duplisere, foregående avsnitt, figurtekster og lærerveiledninger. Flere opplevde de KI-genererte beskrivelsene som altfor lange: «Jeg tror alle er enige om at det er altfor mye irrelevant informasjon i nesten alle beskrivelsene, så det blir altfor mange ord. Og ja, altfor mange ord og litt tolkning på vegne av eleven.» Enkelte beskrivelser var opptil 372 tegn for GPT og 840 tegn for Gemini i kun-bilde-betingelsen, mens kontekst reduserte lengden for Gemini (tabell 1).
Det vesentlige druknet ofte i informasjonsmengden, noe som har praktiske konsekvenser for elever som bruker punktskrift eller skjermleser: «For meg, som bare har fått beskrivelsen, er dette egentlig bare en mølje av ord. Og det er vanskelig å få tak i essensen, og å lese gjennom alt dette i punktskrift går ganske mye saktere enn i visuell skrift, så elevene kommer til å bruke veldig, veldig lang tid på det.»
Modellene la også vekt på perseptuelle trekk som farge (se fig. 1 og tabell 4), noe som sjelden var relevant for undervisningsformålet: «For eksempel, hvis det er en oppgave i boka som bruker fargene, da er det relevant; hvis ikke, er det absolutt ikke relevant.» Samtidig var korthet ikke alltid nok. Når bilder fungerte som samtalestartere i klasserommet, kunne assosiative eller metaforiske elementer være nødvendige for at elever med synsnedsettelse skulle kunne delta i felles læringsaktiviteter.
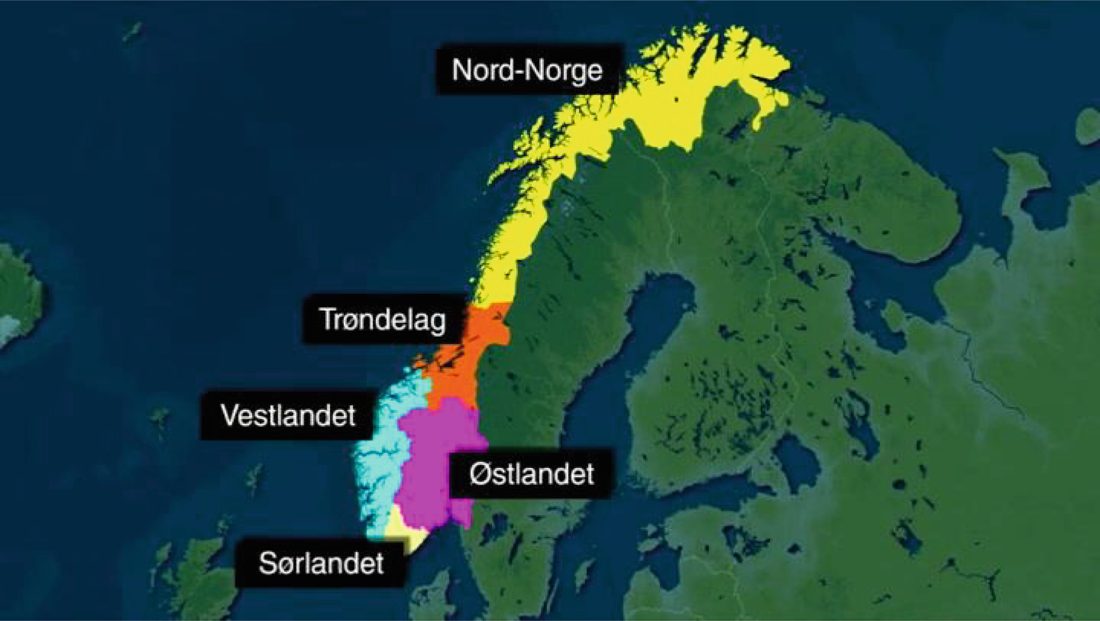
Fig. 1. Norge har fem landsdeler.
Kontekstmisforhold og manglende tilbakeholdenhet
Ekspertene så på tilbakeholdenhet som et sentralt kvalitetskriterium. Kontekst burde etter deres syn hjelpe med å avgjøre hva som kan utelates, slik at beskrivelsen utfyller snarere enn gjentar konteksten. I praksis hadde kontekst ofte motsatt effekt: jo mer kontekst modellen fikk, desto mer tok den med. En deltaker påpekte at KI-en «henter ekstra informasjon fra teksten» i stedet for å «strippe ned teksten og tilpasse den til konteksten». En annen beskrev at modellen «legger det inn i beskrivelsen i stedet for å ta det ut», noe vedkommende omtalte som «det motsatte av hvordan vi tenker når vi skriver». Flere påpekte at dette først ble tydelig i workshopen, der beskrivelser med og uten kontekst kunne sammenlignes direkte.
Større pålitelighet for datafigurer enn for kreative bilder
Deltakerne anså KI-genererte beskrivelser som mer pålitelige utgangspunkt for strukturerte fremstillinger som diagrammer, grafer og skjematiske figurer, der tydelige elementer avgrenser beskrivelsen, enn for kreative eller illustrerende bilder, som inviterer til uønskede slutninger. Også for datafigurer var redaksjonell gjennomgang nødvendig for å fjerne unødvendige detaljer og kontrollere korrekthet.
Tendens til tolkning
Selv om ledeteksten ba modellene unngå «subjektive tolkninger» og ikke gi «forklaringer eller hint som endrer lærings- eller vurderingskonstruktet», inneholdt beskrivelsene ofte slutningsbaserte eller vurderende utsagn. Ekspertene understreket at beskrivelser bør holde seg til det observerbare, slik at de ikke avslører svar elevene selv skal komme frem til. En deltaker spurte: «I hvilken grad skal man fortelle eleven hva bildet illustrerer? Og i hvilken grad skal de få lov til å trekke de slutningene selv?» En annen bemerket at en kun-bilde-beskrivelse antydet at bildet illustrerte temaet kildekritikk, noe som ikke kan utledes av bildet alene.
Trinn- og språktilpasning
Beskrivelsene varierte i ordforråd, setningskompleksitet og klarhet og var ikke alltid tilpasset trinnet. Tallverdier, etiketter og andeler ble iblant presentert tvetydig, for eksempel slik at det var uklart om en prosentandel gjaldt hele befolkningen eller en undergruppe. Romlige beskrivelser kunne også forvirre. Når Nord-Norge ble omtalt som «øverst» og Sørlandet som «nederst» (tabell 4), påpekte en deltaker at kart forholder seg til nord, sør, øst og vest, og at formuleringer som «øverst i nord» kan virke forvirrende. Enkelte beskrivelser hadde dessuten klønete grammatikk eller upresis terminologi, selv når innholdet var korrekt.
| Modell | Betingelse | Beskrivelse |
|---|---|---|
| Menneskeskrevet | Referanse | Et kart som viser Nord-Norge, Trøndelag, Vestlandet, Sørlandet og Østlandet. |
| GPT-5.2 | Kun bilde | Kart over Norge som viser fem landsdeler, fargekodet og merket: Nord-Norge øverst (gult), Trøndelag på kysten i midten (oransje), Vestlandet langs vestkysten (lyseblått), Sørlandet på sørkysten (mørkeblått) og Østlandet i sørøst og innlandet (rosa). |
| GPT-5.2 | Med kontekst | Fargekart over Norge som viser plasseringen av landsdelene: Nord-Norge (gult) helt i nord, Trøndelag (oransje) under Nord-Norge langs kysten i midten, Vestlandet (lyseblått) langs vestkysten, Østlandet (rosa) i innlandet i sørøst og Sørlandet (mørkelilla) på sørkysten mellom Vestlandet og Østlandet. Hver landsdel er merket med et svart navneskilt. |
| Claude-opus-4.5 | Kun bilde | Kart over Norge som viser landets fem landsdeler markert med ulike farger. Nord-Norge er gult og dekker den nordlige delen, Trøndelag er oransje og ligger i midten, Vestlandet er blått langs vestkysten, Østlandet er rosa og ligger i sørøst, og Sørlandet er gult helt nederst i sør. Hver landsdel er merket med navn. |
| Claude-opus-4.5 | Med kontekst | Kart over Norge der de fem landsdelene er vist i ulike farger. Nord-Norge er gult og ligger øverst. Under ligger Trøndelag i oransje. Vestlandet er blått og ligger langs kysten. Østlandet er rosa og ligger i midten mot øst. Sørlandet er gult og ligger nederst på kartet. |
| Gemini-3-pro | Kun bilde | Kart over Norge som viser plasseringen av de fem landsdelene: Nord-Norge er øverst i nord, Trøndelag i midten, Vestlandet langs kysten i vest, Østlandet i øst og Sørlandet helt nederst i sør. |
| Gemini-3-pro | Med kontekst | Et kart der landsdelene er markert med ulike farger. Øverst i nord ligger Nord-Norge. Midt i landet ligger Trøndelag. I den sørlige delen ligger Vestlandet i vest, Østlandet i øst og Sørlandet helt nederst ved kysten. |
5 Diskusjon
Funnene støtter etablert veiledning om at alternativ tekst bør være kort og objektiv og styres av bildets funksjon i konteksten. Deltakerne foretrakk beskrivelser som prioriterte pedagogisk mening fremfor farge, stil og dekorative trekk. Samtidig nyanserer funnene tidligere arbeid som viser gevinster av kontekst (Gubbi Mohanbabu & Pavel, 2024; Kreiss mfl., 2022): modellene behandlet ofte kontekst som ekstra innhold som skulle med, ikke som et filter for utvelgelse. Det ekspertene mener som kontekst for utelatelse, ble hos modellene kontekst for tillegg, med lange beskrivelser, duplisering, hallusinasjon og uønskede slutninger som resultat.
Effekten av kontekst varierte mellom modellene. GPT-5.2 og Claude-opus-4.5 fikk noe høyere skår med kontekst, mens Gemini-3-pro fikk stabile eller lavere skår (tabell 2), noe som tyder på at modellene bruker kontekst ulikt. Deltakerne påpekte at det var krevende å vurdere beskrivelser uten full kjennskap til konteksten, noe også Mack mfl. (2021) rapporterer. At de fleste var lærere og tilgjengelighetseksperter med pedagogisk blikk, kan forklare at bare 18,2 % (klarhet) og 19,4 % (effektivitet) av vurderingene var «Utmerket».
De lange beskrivelsene strider mot kravet om korthet. Personer med synsnedsettelse bruker generelt lengre tid på å lese enn seende (National Center for Accessible Media, 2009), og unødvendige detaljer øker belastningen for skjermleserbrukere ytterligere (Cardia mfl., 2025). Den mangelfulle trinntilpasningen samsvarer med L. Shen mfl. (2025), som fant at KI-generert tekst til lesetrening var mer kompleks enn ledeteksten ba om. Språkfeilene kan skyldes at modellene i hovedsak er trent på engelsk, noe som er vist å gi tverrspråklig interferens (Terryn & de Lhoneux, 2024). Språkrådet (2025) har også påvist grammatiske og syntaktiske feil og engelskpåvirkede uttrykk i KI-generert norsk tekst.
Tolkende beskrivelser og hallusinasjoner innebærer tydelige pedagogiske risikoer. De kan hindre elever i å nå læringsmålene, svekke selvstendig resonnering eller innføre tolkninger som bildet ikke støtter. I tråd med Risi (2025b) understreker resultatene behovet for menneskelig kvalitetssikring, særlig i utdanningssammenheng.
5.1 Begrensninger og videre forskning
Studien har flere begrensninger. Vi brukte zero-shot, og uten eksempler (few-shot) kan modellene ha bommet på tone og terminologi for ulike fag og trinn. Vi brukte også faste genereringsinnstillinger, som temperatur og sampling, og siden disse påvirker hvor lange svar en modell gir, kan enkelte resultater skyldes disse valgene snarere enn modellenes kapasitet. Det lave antallet deltakere begrenser dessuten hvor langt funnene kan generaliseres.
Videre forskning vil prøve ut modeller trent for skandinaviske språk, som NorMistral-11B (Samuel mfl., 2025), samskape ledetekster med tilgjengelighetseksperter og lærere, undersøke hvordan ulike arbeidsflyter påvirker kvaliteten, og gjennomføre brukerstudier med elever med synsnedsettelse.
6 Konklusjon
Vi undersøkte om kontekstuell informasjon forbedrer KI-genererte bildebeskrivelser i læremidler ved å teste GPT-5.2, Claude-opus-4.5 og Gemini-3-pro med 30 bilder fra naturfag og samfunnsfag. Beskrivelsene ble vurdert av 28 deltakere i en spørreundersøkelse og av ni Statped-spesialister i en workshop. Modellene produserte altfor lange beskrivelser som tilslører det vesentlige og øker belastningen for skjermleser- og punktskriftbrukere, og kontekst førte ofte til at beskrivelsene ble utvidet snarere enn avgrenset. Beskrivelsene var mer pålitelige for diagrammer og figurer enn for kreative bilder, inneholdt ofte tolkninger som kan endre læringsutbyttet, og var ikke alltid tilpasset trinnet. Effekten av kontekst varierte mellom modellene, og funnene tillater ikke sikre konklusjoner om at kontekst gir bedre beskrivelser. Menneskelig kvalitetssikring er derfor fortsatt nødvendig.
Takk
Vi takker de ansatte i Statped som deltok i workshopen, og deltakerne som ga verdifulle tilbakemeldinger på spørreundersøkelsen. Vi takker også TV 2 Skole (Elevkanalen) og Nasjonal digital læringsarena (NDLA) for tillatelse til å bruke materialet deres. Forskningen er finansiert av Norges forskningsråd og Statped.
Interessekonflikter. Forfatterne erklærer at de ikke har noen konkurrerende interesser.
Referanser
Liste over referanser
American Foundation for the Blind. (2026). Writing effective image descriptions or “alt text”. Hentet 15. januar 2026 fra https://afb.org/digital-inclusion/accessibility-resources/writing-effective-image-descriptions
Bergheim, P. V. D. (2025). Competence-oriented curricula and the promotion of Bildung: The example of philosophy teaching in Norway. Journal of Curriculum Studies, 57(2), 150-163.
Bertelsen, P. (2024). Gode bildebeskrivelser. Standard Norge. Hentet 30. desember 2025 fra https://uuu.standard.no/docs/editor/Bildebeskrivelser
Bezirhan, U., & von Davier, M. (2023). Automated reading passage generation with OpenAI's large language model. Computers and Education: Artificial Intelligence, 5, Artikkel 100161.
Braun, V., & Clarke, V. (2012). Thematic analysis. American Psychological Association.
Cardia, M., Buzzi, M., Galesi, G., & Leporini, B. (2025). A descriptive review of image datasets for accessible alternative descriptions in STEM domains. I Proceedings of the 16th Biannual Conference of the Italian SIGCHI Chapter (s. 1-7).
Chee, M., & Weaver, K. D. (2023). Writing effective alt-text for online instructional materials. Journal of Technology-Integrated Lessons and Teaching, 2(1), 51-59.
Chung, S. (2024). Children's reading of visuals in informational picturebooks and biographies. International Journal on Social and Educational Sciences, 6(3), 409.
DIAGRAM Center & NCAM. (2015). Image description guidelines. Hentet 7. desember 2025 fra https://diagramcenter.org/table-of-contents-2.html
Gubbi Mohanbabu, A., & Pavel, A. (2024). Context-aware image descriptions for web accessibility. I Proceedings of the 26th International ACM SIGACCESS Conference on Computers and Accessibility (s. 1-17).
Hanley, M., Barocas, S., Levy, K., Azenkot, S., & Nissenbaum, H. (2021). Computer vision and conflicting values: Describing people with automated alt text. I Proceedings of the 2021 AAAI/ACM Conference on AI, Ethics, and Society (s. 543-554).
Hodosh, M., Young, P., & Hockenmaier, J. (2013). Framing image description as a ranking task: Data, models and evaluation metrics. Journal of Artificial Intelligence Research, 47, 853-899.
Hollink, L., Schreiber, A. T., Wielinga, B. J., & Worring, M. (2004). Classification of user image descriptions. International Journal of Human-Computer Studies, 61(5), 601-626.
Hoppe, A., Morris, D., & Ewerth, R. (2021). Evaluation of automated image descriptions for visually impaired students. I International Conference on Artificial Intelligence in Education (s. 196-201). Springer.
Huntsman, S. (2022). An image for all: The rhetoric for writing alt-text. I 2022 IEEE International Professional Communication Conference (ProComm) (s. 49-52). IEEE.
Jandrey, A. H., Ruiz, D. D. A., & Silveira, M. S. (2023). Imagery contents descriptions for people with visual impairments. I Proceedings of the XXII Brazilian Symposium on Human Factors in Computing Systems (s. 1-12).
Kreiss, E., Bennett, C., Hooshmand, S., Zelikman, E., Morris, M. R., & Potts, C. (2022). Context matters for image descriptions for accessibility: Challenges for referenceless evaluation metrics (arXiv:2205.10646). arXiv.
Leotta, M., Mori, F., & Ribaudo, M. (2023). Evaluating the effectiveness of automatic image captioning for web accessibility. Universal Access in the Information Society, 22(4), 1293-1313.
Mack, K., Cutrell, E., Lee, B., & Morris, M. R. (2021). Designing tools for high-quality alt text authoring. I Proceedings of the 23rd International ACM SIGACCESS Conference on Computers and Accessibility (s. 1-14).
McElvany, N., Schroeder, S., Baumert, J., Schnotz, W., Horz, H., & Ullrich, M. (2012). Cognitively demanding learning materials with texts and instructional pictures: Teachers' diagnostic skills, pedagogical beliefs and motivation. European Journal of Psychology of Education, 27(3), 403-420.
Morash, V. S., Siu, Y.-T., Miele, J. A., Hasty, L., & Landau, S. (2015). Guiding novice web workers in making image descriptions using templates. ACM Transactions on Accessible Computing, 7(4), 1-21.
Morris, M. R., Johnson, J., Bennett, C. L., & Cutrell, E. (2018). Rich representations of visual content for screen reader users. I Proceedings of the 2018 CHI Conference on Human Factors in Computing Systems (s. 1-11).
National Center for Accessible Media. (2009). Guidelines for describing STEM images. Hentet 2. desember 2025 fra http://ncamftp.wgbh.org/ncam-old-site/experience_learn/educational_media/stemdx/guidelines.html
NWEA. (2021). NWEA image description guidelines for assessments: Making assessment accessible for all students. https://www.nwea.org/uploads/2022/11/Image-Description-Guidelines-for-Assessments_NWEA_2021.pdf
Perkins School for the Blind. (2026). How to write alt text and image descriptions for the visually impaired. Hentet 15. januar 2026 fra https://www.perkins.org/resource/how-write-alt-text-and-image-descriptions-visually-impaired/
Ripoll y Schmitz, L. M., & Sonnleitner, P. (2025). Evaluating AI-generated vs. human-written reading comprehension passages: An expert SWOT analysis and comparative study for an educational large-scale assessment. Large-scale Assessments in Education, 13(1), Artikkel 20.
Risi, M. (2025a). Accessible images: AI-generated alt text in educational publishing. Logos: Journal of the World Book Community, 49-68.
Risi, M. (2025b). Comparative study on Gen-AI models to write alt text. I International Conference of the Association for the Advancement of Assistive Technology in Europe (s. 217-223). Springer.
Samuel, D., Mikhailov, V., Velldal, E., Øvrelid, L., Charpentier, L. G. G., Kutuzov, A., & Oepen, S. (2025). Small languages, big models: A study of continual training on languages of Norway. I Proceedings of the Joint 25th Nordic Conference on Computational Linguistics and 11th Baltic Conference on Human Language Technologies (NoDaLiDa/Baltic-HLT 2025) (s. 573-608).
Shatford, S. (1986). Analyzing the subject of a picture: A theoretical approach. Cataloging & Classification Quarterly, 6(3), 39-62.
Shen, L., Kane-Cabello, J., Candelaria, P. Y., Stratford, D., & Clemens, N. H. (2025). Can artificial intelligence tools generate text that is useful for reading practice? Learning Disabilities Research & Practice. https://doi.org/10.1177/09388982251352564
Shen, Y., Zhang, H., Shen, Y., Wang, L., Shi, C., Du, S., & Tao, Y. (2025). AltGen: AI-driven alt text generation for enhancing EPUB accessibility. I Proceedings of the 2025 International Conference on Artificial Intelligence and Computational Intelligence (s. 78-83).
Singh, N., Wang, L. L., & Bragg, J. (2024). Figura11y: AI assistance for writing scientific alt text. I Proceedings of the 29th International Conference on Intelligent User Interfaces (s. 886-906).
Språkrådet. (2025). Språket i KI-genererte tekster: Rapport fra Språkrådet om språklig kvalitet i tekster produsert av prateroboter [Rapport]. https://sprakradet.no/wp-content/uploads/Rapport-fra-test-av-sprakroboter-2025.pdf
Standard Norge. (2025). Gode tekstalternativer (WCAG 1.1.1). Hentet 12. januar 2026 fra https://uuu.standard.no/docs/editor/111
Sundby, A. H., & Karseth, B. (2022). ‘The knowledge question’ in the Norwegian curriculum. The Curriculum Journal, 33(3), 427-442.
Terryn, A. R., & de Lhoneux, M. (2024). Exploratory study on the impact of English bias of generative large language models in Dutch and French. I Proceedings of the Fourth Workshop on Human Evaluation of NLP Systems (HumEval) @ LREC-COLING 2024 (s. 12-27).
W3C Web Accessibility Initiative. (2022). Images tutorial. Hentet 25. januar 2026 fra https://www.w3.org/WAI/tutorials/images/
WebAIM. (2025). The 2025 report on the accessibility of the top 1,000,000 home pages. Hentet 21. januar 2026 fra https://webaim.org/projects/million/
World Wide Web Consortium. (2018). Web Content Accessibility Guidelines (WCAG) 2.1 [W3C-anbefaling]. https://www.w3.org/TR/WCAG21/
Wu, S., Wieland, J., Farivar, O., & Schiller, J. (2017). Automatic alt-text: Computer-generated image descriptions for blind users on a social network service. I Proceedings of the 2017 ACM Conference on Computer Supported Cooperative Work and Social Computing (s. 1180-1192).